Mimo’yu, bir tercih değiştiğinde eski bilginin ne zaman geçerli olduğunu kaybetmeden cevap verebilmek için geliştirdim. Özgün mesajları yerelde sakladım; kişi, konuşma, kapsam ve zaman bilgisini yanıtın parçası yaptım.
Değişen tercihler için kaynaklı ve zamana bağlı hafıza
Katkım
Yerel hafıza modelini, zaman çözümlemesini, üç yöntemli karşılaştırmayı ve sorgu arayüzünü geliştirdim.
Yıl
2026
İçindekiler
Değişen bir tercihi kaynağıyla hatırlamak
Mimo’yu küçük bir hafıza sorusu etrafında geliştirdim: bir kişi kahvesine şimdi veya geçmişte kaç şeker koyuyordu? Asıl zorluk, tercihin değiştiği yerde başlıyor. Eski mesaj, soruya metin olarak çok benzese bile daha sonraki bir düzeltme yüzünden geçerliliğini kaybetmiş olabiliyor. Yanıtı, dayandığı özgün mesajla birlikte görmek istedim.
Bu davranışı açık biçimde kurabilmek için yerel Python uygulaması ve SQLite kullandım. Kahvedeki şeker sayısı, düzeltmeleri, hafta sonu tercihlerini ve çelişkili ifadeleri tek tek inceleyebileceğim dar bir alan sağladı. Her cevabın hangi kaynaktan geldiğini ve o kaynağın hangi zaman aralığında geçerli sayıldığını takip edebiliyordum. Böylece çıkarım, zaman seçimi ve yanıtın gösterimi üzerinde ayrı ayrı çalışabileceğim bir uygulama ortaya çıktı.
Düzeltmenin öncesini ve sonrasını sormak
Ayrı bir tanı örneğinde 1 ve 2 Ocak’ta şeker sayısını bir, 3 Ocak’taki düzeltmeyle sıfır yaptım. 4 Ocak’ta bir arkadaşın mesajı, konuşmanın son zamanını ileri taşıyor. Güncel tercihi sorduğumda eski cümle soruya daha çok benzese de düzeltilmiş değerin gelmesi gerekiyor.
Sözcük benzerliğine dayalı yöntem r1 kaynağından eski değer olan biri döndürdü. Zamansal yöntem ise r9 kaynağından sıfırı verdi. Bu örneği ana karşılaştırmanın puanına eklemedim; belirli bir güncellik hatasını açıklamak için ayrı tuttum. Daha eski bir tarih sorulduğunda da o tarihteki değeri korumak gerekiyor. Sonraki düzeltmenin geçmişi silmemesi, aynı konuşmaya farklı zamanlardan bakabilmemin temel koşulu oldu. Kaynak kimlikleri, bu farkı sonuçta doğrudan kontrol etmemi sağladı.
Değişen tercihi ve önceki kaydı aynı katlı kâğıtta tuttum.
Kanıtı ekleyip yanında soru sormak
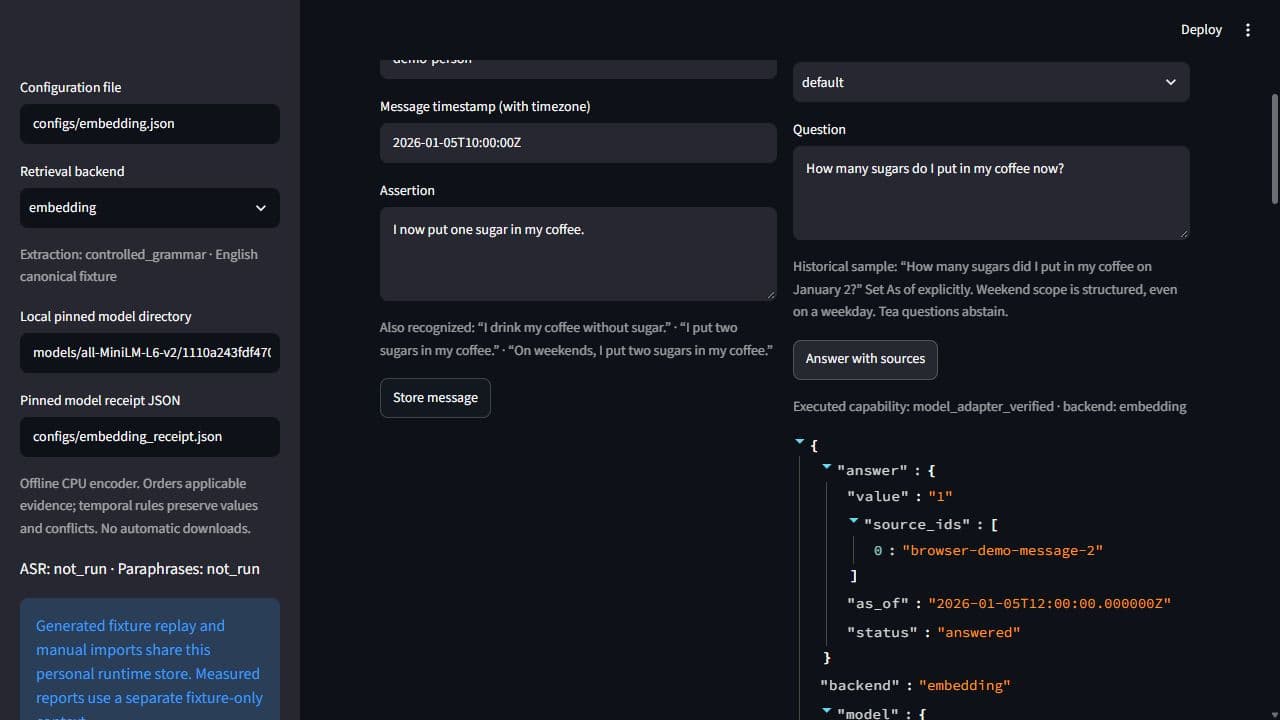
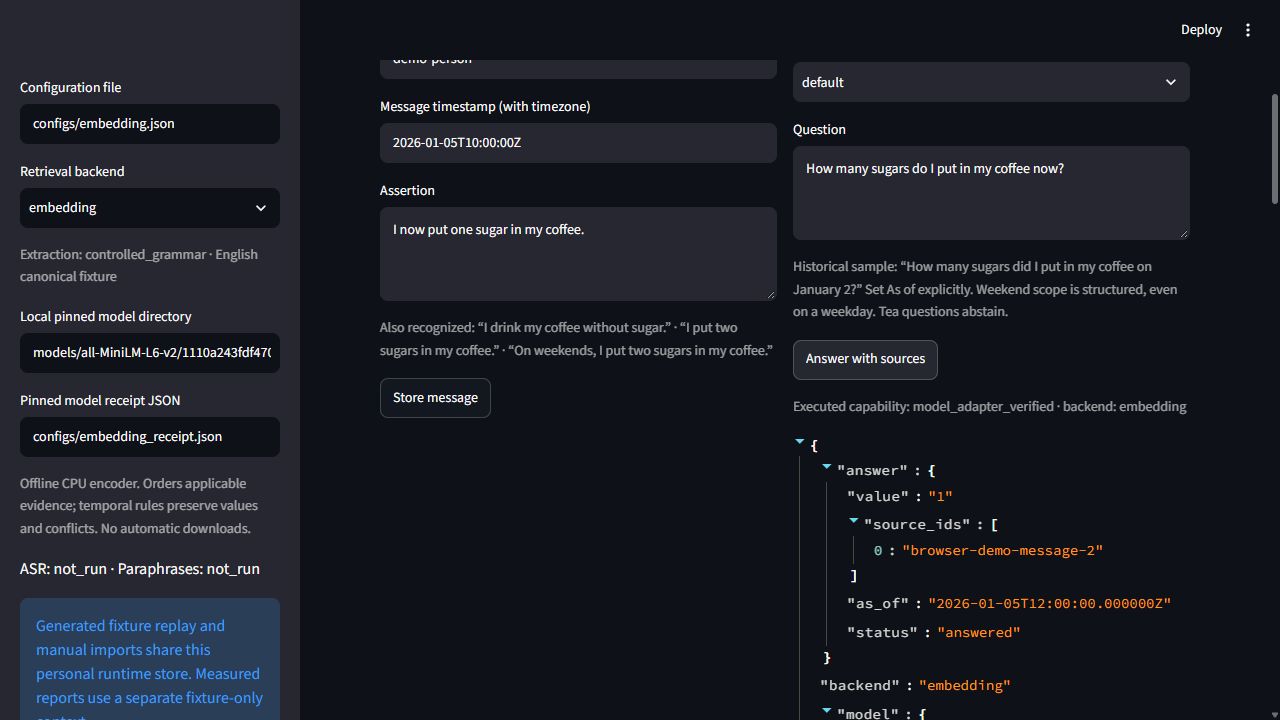
Streamlit ekranını özgün mesaj ekleme ve soru sorma olarak iki sütuna böldüm. İlk form mesaj kimliğini, konuşmayı, kişiyi, zaman damgasını ve ifadeyi alıyor. İkinci formda konuşma ve kişi tekrar açıkça seçiliyor; sorgu zamanı ile varsayılan veya hafta sonu kapsamı ekleniyor. Bu alanları görünür tutarak cevabın hangi koşullarda üretildiğinin okunmasını sağladım.
Sonuçta yapılandırılmış yanıtın yanında özgün mesajlar gösteriliyor. Açılabilir zaman çizelgesinde türetilmiş bilgilerin geçerlilik aralıkları görülebiliyor. Yöntem seçimi yan panelde; kodlayıcı seçilirse yerel model dizini ve doğrulama kaydı alanları açılıyor. Deney verisini tekrar yüklemekle elle mesaj eklemek kişisel çalışma deposunu kullanıyor. Ölçüm ise ayrı bir deney deposunda yapılıyor. Ekranda denenen bir örnek, kaydedilmiş karşılaştırmanın veri kümesini değiştirmiyor.
Uygulama ekranları
1 / 3
Dönen tercihin yanında özgün mesajı ve geçerli zaman bilgisini gösterdim.
Yirmi konuşmada yüz mesaj ve yüz soru ürettim. Konuşma ve kişi kimliklerini on iki eğitim, dört doğrulama ve dört test grubu arasında ayırdım. Bilgi çıkarıcı dört kontrollü kahve ifadesini ve dört soru kalıbını tanıyor. Deney senaryolarında desteklenmeyen içeriklerle birlikte beş ifade ve beş soru şablonu tekrar ediyor.
Bu tekrar, tanımladığım davranışları karşılaştırmayı kolaylaştırıyor; alışılmadık bir cümlenin nasıl işleneceği ise ayrı bir deney gerektiriyor. Sözcük temsillerini yalnız altmış eğitim mesajına göre kurdum. Test konuşmalarının mesajları, yanıt sırasında aranabilen geçmiş olarak depoda bulunuyor. Hafıza sorusuna cevap verebilmek için o geçmiş gerekiyor. Beklenen cevapları arama verisine katmadım; yalnız tahminler üretildikten sonra değerlendirmede kullandım. Eğitimde öğrenilen dönüşümle sorgu anında görülen kanıtı bu şekilde ayırdım.
Özgün mesajla türetilmiş bilgiyi ayırmak
Özgün mesajları kanıt olarak saklayıp kullanılabilir bilgileri onlardan türettim. Her bilgi bir konuşmaya, kişiye, niteliğe ve kapsama ait. Geçerliliği ifadenin zamanında başlıyor, daha sonraki düzeltmenin zamanında bitiyor. Başlangıcı dahil, bitişi hariç aralıklar kullandım. Böylece düzeltmenin geldiği anda yeni değer geçerli oluyor; art arda iki değerin aynı anı paylaşması gerekmiyor.
Zaman damgalarını doğrulayıp UTC’ye dönüştürüyorum. Yapılandırılmış kişi, kapsam ve sorgu zamanı alanları belirleyici; soru metni bunları sessizce değiştirmiyor. Sorgu zamanı boşsa konuşmadaki en son mesajın zamanını kullanıyorum. Bu mesajın çıkarıcının tanıdığı bir bilgi taşıması da gerekmiyor. Komut satırı ve arayüz aynı çekirdek işlevleri çağırıyor. Aynı zaman seçimi, uygulamanın iki kullanım biçiminde de aynı kurallarla yapılıyor.
Metin benzerliğinin ne getirdiğini ölçmek
Başlangıç karşılaştırmasında TF-IDF kullandım. Bu temsil, sözcüklerin veya karakter parçalarının ağırlığını metinlerde görülme sıklıklarına göre hesaplıyor. Sözcük ve karakter temsillerinin yönünü karşılaştıran kosinüs benzerliklerini ortalayıp uygun mesajları sıralıyorum. Sözlük ve ağırlıkları eğitim metninde kurduktan sonra tahmin sırasında sabit tutuyorum.
Bu yöntem de başka konuşmaları, başka kişileri ve henüz gerçekleşmemiş kaynakları dışarıda bırakıyor. Ancak geçerlilik aralıklarıyla eski değerin yerini yenisinin almasını çözmüyor. Düzeltmeden sonra yalnız benzerlikle aramanın ne kaçırdığını böyle inceleyebildim. Yanıtsız kalma eşiğini doğrulamada, test puanından önce seçtim. Yöntemlerin ortak kimlik ve zaman sınırlarını korumak önemliydi. Bir karşılaştırma farkının yanlış kişinin geçmişini okumaktan değil, uygulanabilir kanıtı ele alış biçiminden gelmesini istedim.
Yanıttan önce geçerli bilgileri seçmek
Zamansal yöntem, sorgulanan anı kapsayan bilgi aralıklarını seçiyor. Hafta sonu sorusunda o anda geçerli bir hafta sonu tercihi varsa öncelik ona veriliyor; yoksa varsayılan tercih kullanılıyor. Varsayılan sorular hafta sonu bilgilerini dışarıda tutuyor. Aynı değerin tekrar söylenmesi ek kaynak sağlayabiliyor, fakat her kaynak ancak kendi zamanından itibaren görünür oluyor.
Aynı geçerlilik anında farklı değerler verilmişse ikisini de koruyup çelişki durumu üretiyorum. Dosyadaki sıra, hangi ifadenin kazanacağını belirlemiyor. Daha sonraki bir düzeltme aynı aralık kurallarıyla bu durumu kapatabiliyor. Sonuçları cevaplandı, bilinmiyor ve çelişki olarak ayrı durumlarla döndürdüm. Arayüz böylece kanıt eksikliğiyle birbiriyle uyuşmayan kanıtları ayrı gösterebiliyor. Özgün mesaj kimlikleri her durumda sonucun yanında kalıyor; inceleme sırasında ilgili kayda geri dönebiliyorum.
Kodlayıcıya belirli bir görev vermek
İsteğe bağlı sabit sürümlü CPU cümle kodlayıcısını, zamansal seçimden sonra ekledim. Kodlayıcı metni sayısal vektöre çeviriyor; kosinüs benzerliği de uygun kaynakların sırasını belirliyor. Modeli açıkça belirtilen yerel dizinden, içerik doğrulamasıyla yüklüyorum. Çalışma sırasında aynı model örneğini yeniden kullanıyorum; vektörler ise sorgu için hesaplanıyor.
Bu bileşenin görevi kanıtı sıralamak. Çelişkili bir değeri atıp tek cevap üretemiyor. İlk birkaç sonucu tutan bir kesme veya benzerlik eşiği uygulamıyorum; bütün geçerli kaynaklar korunuyor. Sıralama izi gerçek skorları gösterirken son yanıtın kaynak kimlikleri kararlı bir küme olarak dönüyor. Model dosyası veya bağımlılık eksikse isimlendirilmiş bir yöntem hatası oluşuyor. Seçilen yöntem başarısız olduğunda başka bir yöntemle üretilmiş sonucu onun adı altında göstermiyorum.
Üç yöntemin neden aynı sonuca vardığını görmek
Kaydedilmiş testte yirmi soru var: on altısı cevaplanabilir, dördü desteklenmiyor. Sözcüksel, zamansal ve kodlayıcılı yöntemlerin üçü de yirmi sorunun durumunu, değerini ve tam kaynak kümesini doğru döndürdü. Değeri değişmiş dört soruda eski yanıt sayısı sıfırdı. Ana testte çelişki örneği bulunmadığından çelişki kesinliği ve duyarlılığı için hesaplanabilir bir payda yoktu.
Adayları incelemek eşitliğin sebebini gösterdi. Zamansal seçimden sonra cevaplanabilir on altı sorunun her birinde yalnız bir geçerli bilgi kalıyor. Kodlayıcının sırasını değiştirerek cevabı iyileştirebileceği aday yok. Desteklenmeyen dört soru da kodlamadan önce dil kuralında duruyor. Sonuçları önceden bilinen bu veriyle yapılan model entegrasyonunu, çalışma yolunu ve kuralları doğrulamak için kullandım. Anlamsal sıralamanın katkısı başka bir deney düzeni istiyor.
Modelin çalışma maliyetini de korumak
Doğrulukla birlikte kaydedilmiş CPU sürelerini ve ölçüm sınırlarını da tuttum. Her yöntemde yirmişer sıcak, tek sorguluk işlem SQLite erişimini, dönüşüm veya kodlamayı, sıralamayı ve yanıt üretimini kapsıyor. Medyan süre sözcüksel yöntemde 11,788 ms, zamansal yöntemde 2,969 ms, kodlayıcıda 20,073 ms idi. Karışımda hızlı biten dört desteklenmeyen soru da var; model on altı istekte gerçekten çalışıyor.
Yerel dosya doğrulaması ve ilk deneme kodlaması dahil soğuk model başlangıcı ayrıca yaklaşık 7,856 saniye sürdü. Bu süreleri kaydedilen makine ve iş yüküyle birlikte okuyorum. Ana sorularda yöntemler eşitken, ek model maliyetinin değerini göstermek için sıralamanın cevabı etkileyebileceği örnekler gerekiyor. Tek aday bulgusunu sürelerle birlikte değerlendirmek, sonraki çalışmayı hangi sorular üzerine kuracağımı belirlememe yardımcı oldu.
Depolama ve eski sonuç sorunlarını düzeltmek
İncelemede, yalnız SQLite güncelleme ve silmelerini reddetmenin yeterli olmadığını gördüm. Olağan REPLACE işlemi özgün kanıtı koruma kuralını aşabiliyordu. Aynı kimlikle yeni eklemeyi engelleyen kontrol ekledim; API üzerinden tamamen aynı kaydın tekrar gönderilmesini güvenli tuttum. Kimliği aynı, içeriği değişmiş mesaj artık reddediliyor. Windows’ta yeniden üretilen kilit sorunu için de bağlantı yardımcısının işlemi tamamlamanın yanında bağlantıyı kapatmasını sağladım.
Soru çalıştırılmadan önce eski cevabı temizliyorum. Hatalı tarih, önceki başarılı yanıtı ekranda bırakmadan isimlendirilmiş hata veriyor. Desteklenmeyen çay sorusu ise model çağrısı olmadan bilinmiyor dönüyor. Böylece seçilmiş yöntem ile o istekte gerçekten çalışan yol ayrı okunabiliyor. Ekranda görünen sonucun hangi isteğe ait olduğu, hata durumunda da açık kalıyor.
Sonraki çalışmayı yeni sorularla kurmak
Sonraki adımda, ayrıştırıcıyı değiştirmeden önce ayrı bir farklı ifade kümesini sabitlemek istiyorum. Böylece alışılmadık cümlelerde bilgi çıkarma ve yanıtsız kalmayı ölçebilir, mevcut kanonik deneyi karşılaştırma olarak koruyabilirim. Doğal konuşma verisi için kullanım izni ve kaynağıyla birlikte konuşma, kişi ve zaman ayrımlarını ayrıca tanımlamak gerekiyor.
Kodlayıcı tarafında birden fazla geçerli kaynağın ve bağımsız belirlenmiş ilgililik etiketlerinin bulunduğu bir düzen kurmalıyım. Ayrı çelişki kontrolleri gerçek skorların sırayı etkilediğini, çelişkili kaynakların korunduğunu gösteriyor; sıralama başarısını ölçen veri sağlamıyor. Modelin ek maliyetine karar vermeden önce bu değerlendirmeyi hazırlardım. Mimo’da adayların nasıl oluştuğunu incelemek, doğruluk tablosunu okumak kadar gerekli oldu. Tek geçerli adayın bulunduğu sorularda yüksek puan, yeni bileşene yararlı bir seçim görevi vermiyor.